Wednesday, 27 November 2019

量子算命,在线掷筊:一个IBM量子云计算机的应用实践,代码都有了

AI科技大本营 · 8小时后
来,我用量子力学给你算一卦。
编者按:本文来自微信公众号“AI科技大本营”(ID:rgznai100),整理 Jane,36氪经授权发布。
“算命”,古今中外,亘古不衰的一门学问,哪怕到了今天,大家对算命占卜都抱着一些”敬畏“的信任心理,西方流行塔罗牌,国内有掷筊(jiǎo)等“卜卦”之术,国内尤以古老的文献之一《易经》为大家熟知。
《易经》最初用于占卜和预报天气,以一套符号系统来描述状态的简易、变易、不易,中心思想是以演译自然运行的内在特征与规律,解读阴阳的交替变化描述世间万物,也可以用一个数学知识来解释:我们计算分析,归纳总结的是随机现象。
一种传统的问卜仪式:掷筊
不过,时代变了,当代占卜大师或许也要考虑饭碗被计算机替代的问题了。
现在,日本一位华人工程师在其个人网站和Github主页上上线了两个新项目:《量子算命,在线掷筊:IBM 量子云计算机使用入门》、《量子算命:爻 System》,希望通过量子力学让你足不出户,和神明通个电话。
前有“AI面相学”,今有“量子神明”出世了,没准两者合计一下兴许可以找风投要钱办公司打开新(圈)市(钱)场了?

“量子神明”的诞生

项目作者在《量子算命,在线掷筊:IBM 量子云计算机使用入门》中表示:如果我们今天对量子力学的认识是正确的,那么随机性应该是量子物理的内禀性质。
量子算命,在线掷筊:一个IBM量子云计算机的应用实践,代码都有了
基于此,他提出一个利用量子力学现象进行随机数的发生的方法,并且已经采用 IBM 的量子云计算机 IBM Q 实现了。利用 IBM 提供的量子程序开发的 SDK,在设计调试完成后,交给线上真正的云量子计算机进行运算。
万万没想到,这款量子计算应用真的就这样诞生了?

原理是什么

在第一个项目中,他以「掷筊」为例,为大家从方法假设到代码实现一一解释。
掷筊是一种道教与民间信仰中问卜的仪式;又称掷筶、掷杯、博杯,普遍流传于华人民间传统社会。“筊杯”是一种占卜工具,是世俗之人所用以与神明指示的工具。下列是阳阴组合的说明:
(1)一阳一阴(一平一凸):称之为“圣筊”、“允筊”(筊或作“杯”)表示神明允许、同意,或行事会顺利。但如祈求之事相当慎重,多以连续三次圣杯才算数。
(2)两阳面(两平面):称之为“笑筊”(筊或作“杯”),表示神明一笑、不解,或者考虑中,行事状况不明,可以重新再掷筊请示神明,或再次说清楚自己的祈求。
(3)两阴面(两凸面):称之为“阴筊”、“无筊”、“怒筊”(筊或作“杯”),表示神明否定、愤怒,或者不宜行事,可以重新再掷筊请示。(解释来源:维基百科)
作者是这样假设与设计的:
量子算命,在线掷筊:一个IBM量子云计算机的应用实践,代码都有了
提出的方法:
量子算命,在线掷筊:一个IBM量子云计算机的应用实践,代码都有了
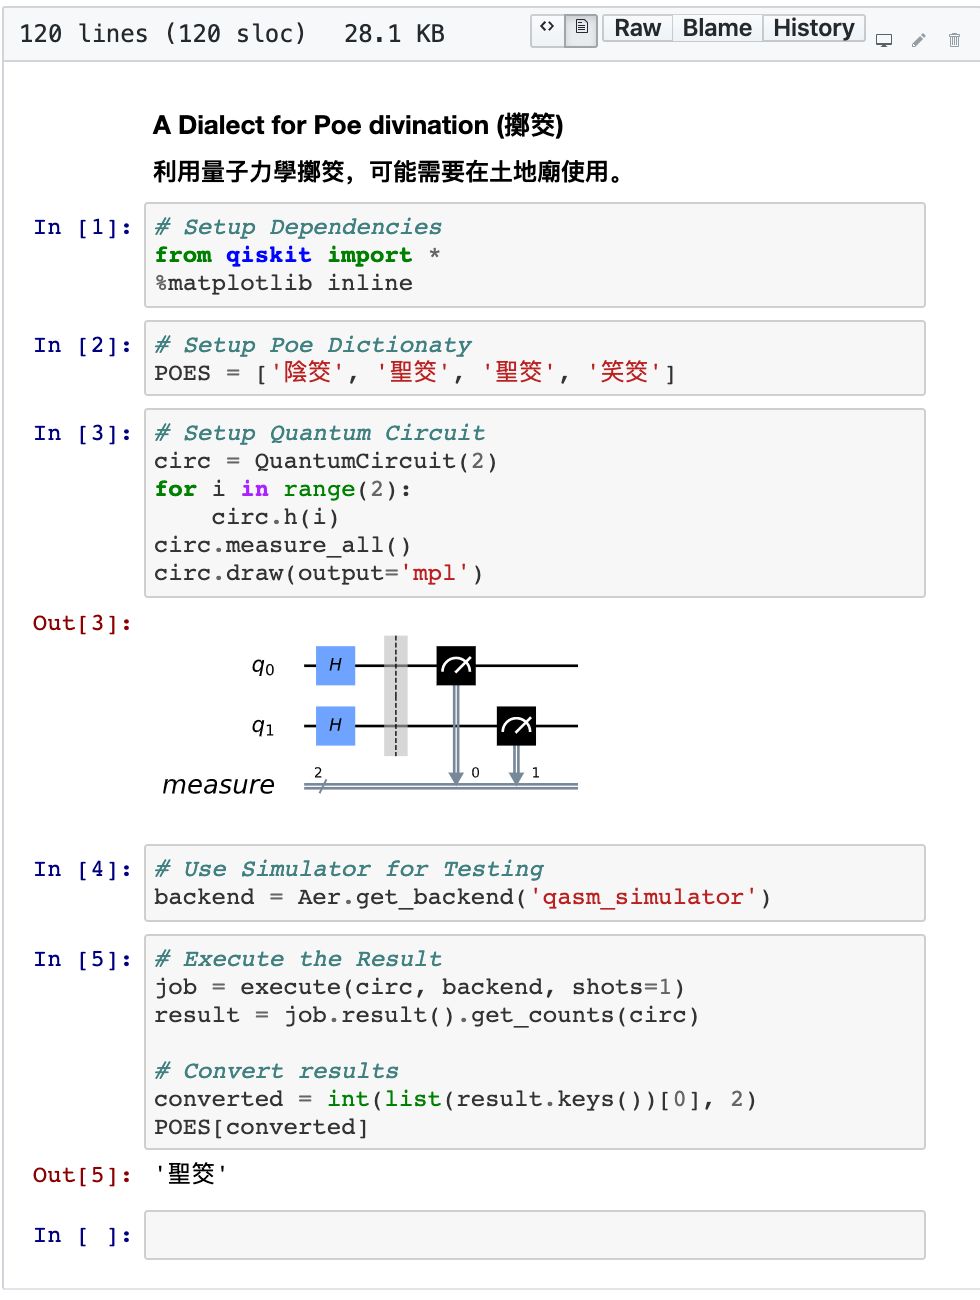
基于 IBM 提供的量子程序开发的 SDK,部分代码:
量子算命,在线掷筊:一个IBM量子云计算机的应用实践,代码都有了
github在这里:
上面「掷筊」的例子中,情况没有那么复杂,相对容易理解与实现。随后,作者还进行了第二个项目《基于量子计算的爻系统》的设计与开发,这个项目是基于《易经》的六爻占卜设计的:
《易经》八卦中有两个符号,一个是“⚊”,另一个是“⚋”。在《易经》中并没有“阴阳”二字,数百年后的《易传》才把“⚊”叫阳爻,把“⚋”叫阴爻。八卦是以阴阳符号反映客观现象。
 六爻,既可以指从下向上排列的六个阴阳符号的组合,也泛指借用这种组合进行预测的方法。六爻预测,包括纳甲法和梅花易数两种不同方法,纳甲将六个爻结合天干地支五行六亲世应及神煞等众多因素来预测,而梅花易数比较简便,主要依据内外卦、体用卦、互变卦及爻辞等来预测。(解释来源:维基百科)
量子算命,在线掷筊:一个IBM量子云计算机的应用实践,代码都有了
在这个设计中,明显计算复杂了很多,需要 64 个经典态,即需要 6 个量子,但 6 个量子的量子芯片目前仍十分稀有。作者表示:“由于在他们设计的占卜过程中不需要产生任何纠缠态,只需要 H 门这一种量子门,可以针对这一市场需求设计并行的单量子芯片,从而让量子计算走入千家万户“。
上代码,看看怎么算卦的:
这几年,深度学习算法在计算机视觉图像识别领域不断取得突破,随之产生了不少新鲜应用,“AI识面”这一类项目引发了大家的关注与讨论。
这一类应用基本都属于算命中的面相学,这样通过用户的照片,结合“大师点评”,让看面相这件事不仅具有历史底蕴,还有了科学解释性,不过依然是专收“智商税”的。此前,AI科技大本营此前报道过此类小程序。
现在,这类收“智商税”的算卦应用,有了更时尚的装饰名词:量子神明。
作者还说了,“建议大家以后问鬼神的时候可以多用量子神明的力量,可能会比较凖(编者注: 同'准')吧。”
会准吗?无论如何,这个项目的 Slogan 是有了:真 · “遇事不决,量子力学”。

Tuesday, 29 October 2019

用“费曼学习法”理解区块链

“以教代学”的“费曼学习法”

很多人都听说过“费曼学习法”。
以前有一句话:“如果你不能简单地解释一件事,那你就还没有弄懂它”,物理学家费曼将这个道理变成一套方法,核心是学习的过程中,假想你面前有一个和你一样的外行人,你得现学现卖,而且只能用他能懂的语言去解释。
传统的新知识学习,往往要用一些术语去表达概念,但我们对这个术语的本身,包括术语与其他知识的关系,理解是含糊。
比如“区块链”,你如果仅仅用“分布式数据存储、点对点传输、共识机制、加密算法”这些术语去理解“区块链”,显然是自己糊弄自己。
为了让外行理解,你要放弃术语,而一旦放弃了术语,你会立刻发现,你对一件事的理解并没有你想像的那么透彻,那么,你再回头研究其中的问题在哪儿,这个学习的过程,被称为“费曼学习法”。
“费曼学习法”核心就是“以教代学”,因为以“听、看、阅读”为主的被动学习,以学习效率远远低于以“讲述、讨论”为主的主动学习。
用“费曼学习法”理解区块链,你也可以做到
“费曼学习法”是我最常用的学习方法。
我过去写文章解释新概念时,大量使用类比的方法,很多人觉得这种方法需要深度理解之后,其实不然,很多类比,都是在我学习的过程产生帮助自己理解的。
下面的例子,是我前年学习“区块链”技术时的理解。因为我不是理科出身,所以理解难免有偏差,仅仅是帮助大家理解“费曼学习法”,而非“区块链”科普文。

去中心化的火车站

小镇上有一家火车站,火车站自己有一个售票系统,卖一张票就勾掉相应的班次位置,这个方法就是“中心式记账”,好处是有专门的人去管理,乘客不需要接触整个售票系统,只要凭票在规定时间上车,对号入座即可。
可过了一段时间,乘客们经常发现两张票对应同一个座位,这没道理啊?于是大家找站长算账。
站长冷笑一声把售票系统打开,说:“每一张票的出售记录都清清楚楚地写在上面,你们不相信,就自己来查……,如果没有问题,我就要问问你们,票是从哪儿买的?”
大家一时语塞,因为火车票很紧张,所以相当一部分乘客都从黄牛手上买票,难免有些黄牛乘机伪造火车票。乘客只好自认倒霉。
可时间一长,超载的现象越来越严重,简直把火车变成了公交车,而且,大家并不没有觉得黄牛变多啊。
越来越多的人开始怀疑火车站故意超售,否则,受黄牛影响最大的是他们,他们为什么不管呢?
愤怒的小镇人民一起跑到火车站,一把火把站给烧了,把站长和贪污的售票员痛打一顿,赶出了小镇。
痛快是痛快,可还得有人卖票啊?只要是“中心式记账”,谁敢保证下一个站长不贪污呢?就算站长不贪污,黄牛的问题也是要解决的。
这时,小镇的居民中有一个叫“中本聪”的人站出来说,我有一个好办法,不需要火车站,也能人人买到票。
“中本聪”将火车票按发车时间顺序自动分批提前做出来,以ITO(首次火车票发售)的方式先出售给每一个市民指定的代理人。如果市民A要坐某一趟火车,他就需要向持有该票的市民B买——都是点对点的交易,自然就不需要火车站了。
用“费曼学习法”理解区块链,你也可以做到
这就是一个“去中心的分布式数据存储系统”,可是,如果不是在火车站买的,市民A怎么能保持市民B卖给他的票是真的呢?
“中本聪”的办法是给每一个小镇居民发一个自动记账的账本,只要有一个人得到了一张票,他身份信息、购买时间、座位号都会自动记载到每一个人的账本上。实际上没有火车票了,而是一条信息:“张三得到一张火车票,座位是XXX,区块123”——这就是“区块链”的“区块”。
请注意,这个编号123的区块,记载在小镇每一个人的账本上,自然任何一个人都无法再伪造这张票,每一个人的票都是真的。
然后,当市民A从市民B手上买到火车票,他得到的不是也不是火车票,而是一条转让记录:“张三得到一张火车票,座位是XXX,区块124,上一条123”——同样向全体居民的账本上发送。
每一条信息都对应着“上一条”的信息,证明这张票的来源是可靠的——这就是“区块链”的“链”,也是它最大的优势:不可删除性,可追溯性。
用“费曼学习法”理解区块链,你也可以做到
这么一来,整个小镇居民不需要火车站售票系统,就可以自发的完成买票、换票等一系列工作。
……
上面就是我当初用“费曼学习法”理解“区块链”的一部分,这种方法很慢,但一些很复杂的知识,如果要自学,往往需要这个方法才能真正掌握。
“费曼学习法”最经常遇到的问题,是编了一半实在编不下去,这恰恰在提醒你,有一个知识点的逻辑关系你没有掌握,必须重新理解,再回头修改。
上面的内容大家读得很顺,那是因为我在理解过程中,不断修改这个例子:我一开始是用“挖矿”来类比,后来意识到,“挖矿”不好理解“链”的概念,后来换成了“电影票”,又意识到转让“电影票”挺奇怪,最后才改成了“火车票”。
一开始,我用火车票的座位号去理解“链”,但后来发现理解的不对,座位号是火车的“链”,火车票才是交易区块的“链”。
在不断修正这个例子的过程中,我对“区块链”的理解也越来越深,忽然在某一个时刻,打通了逻辑。
“火车票”的例子之所以合适,因为区块链解决的信任问题刚好也是火车票在现实中的问题,大家比较好理解。后来,我竟然发现真的有人探讨用区块链技术解决火车票的问题。这就更说明“费曼学习法”的价值了——你不但学习了知识,还掌握了知识的应用。
不过,每一个比方在帮助你理解了一个属性后,也可能让你忽视和误解另一个属性。
比如这个火车票的例子,比较容易去解释“区块链”的“分布式存储”,但却忽略了另一个重要的特征“共识机制”。
当然,一般人对区块链的认识到“分布式存储”就可以结束了,但如果你是对此特别感兴趣,或者是创业者,或者相关行业的非技术从业人员,或者像我这样的职业投资者,一定会考虑一个问题:
区块链跟我有什么关系?
而这才是“费曼学习法”的深度应用。

区块链不可能三角形

费曼学习法的第一步是“明白学习目标”,看上去简单,不就是弄明白什么是“区块链”吗?
但当你解决了这个目标后,你自然会产生一个新的目标——“区块链”对我而言的意义是什么。
新知识就像一个孤岛,刚才通过“费曼学习法”的过程,好像一次新大陆的航行,确定了“新大陆”的位置,但接下来呢?如果你觉得这里有可能有资源,你就需要进行勘探发掘。
“费曼学习法”的方法仍然是把新知识与旧知识联系,只不过,这一次,我们的目的不是理解,而是比较。
仍然以“区块链”为例,上面的类比留给我一个疑问——转让一张火车票,要在所有人的账本上都记上一笔?那怎么保证一条信息过来,大家都正确地记账?要是不在线怎么办?要是有人故意乱记怎么识别?……
事实上,因为不可能每个人同时一起记账,所以每一个新区块只能由一个人负责记,然后大家“抄作业”,但现在是“去中心”了,“老师”已经没有了,那么如何挑出一个可信任的“记账人”,这就需要一个“共识机制”。
最早的共识机制叫“工作量证明”,就是比特币中的“挖矿”,用比拼算力暴力破解密码的方式来竞争记账权,获胜者的回报就是“奖励币”和转账手续费。
为什么算力可证明一个人的可信呢?“工作量证明”就像科举中的“八股文”,挖矿就像中举,奖励币就像当官。做官本身并不需要“八股文”,但因为难度大,而且需要你投入大量精力,所以可以证明一个人的智商和意志力,这同样是当官所必须的。
这种算法绝对无法造假,又绝对是“去中心化”,但它毫无意义地消耗了大量计算与电力资源,这种低下的效率,除了造币还真没什么别的用处。
针对“工作量证明”的缺点,有人设计了的2.0版、3.0版的算法共识,或者根据持币时间长短和数量取得记账权,或者民主投票产生记账权的代理人,这就不需要“挖矿”,交易效率高了,但缺点是不那么“去中心化”,而且“安全性”也没有那么强。
所以就有人提出了一个“区块链不可能三角形”——不可能同时兼顾效率、去中心化程度、安全。
用“费曼学习法”理解区块链,你也可以做到
可以说,在我学习“共识机制”的过程中,正是这个熟悉的词——不可能三角形,一下子打通了我的“奇经八脉”,所有关于“区块链”的逻辑一下子被这个“不可能三角形”贯穿了。
“去中心化”不是绝对的,区块链应用实际上是在这三者之间进行平衡:版权保护要的是的版权确认与分销的“效率”;区块链游戏要的是玩家物品的“安全性”;资源共享类应用要“去中心化”……,为产品开发更合理的共识算法,正是区块链工程师最核心的工作之一。
这也就解决了此前我最大的疑惑:为什么“区块链”一下子上升到国家意志层面?
分析一下这个“不可能三角形”,“安全”不是指网络安全,而是系统可用性,是区块链最核心的价值,不能没有;“效率”是商业化应用的前提,也要有;那唯一可牺牲的就是“去中心化”的程度了。
政府肯定是不喜欢“去中心化”的,每一个“中心”都代表一项权力,就像前面的“去中心化火车票”让站长失业一样,这也是之前有关部门一直视比特币为洪水猛兽的原因。
但“去中心化”确实又有好处,可以降低行政成本,提高办事效率。
更重要的是,虽然区块链技术的应用方向很多,但唯一能够影响国家决策层意志的还是金融,从国际竞争的角度看,“去中心化”就是“去美元霸权”,对政府就是有战略意义的技术。
这就解释了,为什么央行早在2014年就一直在研究的数字化货币DCEP,在脸书推出天秤币后,忽然加速。
天秤币以美元作为记账单位,代表了“美元霸权”在数字货币领域内的延伸,美联储已经基本同意,只在国会有压力,所以小扎在美国国会高调作证,办法就是用“中国人已经大幅领先”制造悲情效应。
不管你愿不愿意,“区块链”已经上升到国家竞争的层面。
事实上,区块链未来第一个杀手级应用已经很明显,即跨境支付,美国主导的SWIFT协议结算周期平均需要3-5天,其中交易确认就需要1-2天,理论上用区块链技术可以让跨境变成T+0结算,毫无疑问可以在这个基础上诞生很多新的商业模式。
所以天秤币的初始成员中就有Visa、Mastercard、PayPal等金融支付机构。
如果能把“去中心化”的影响控制在一定的层面,又能争取“安全”“效率”,区块链很可能是下一场“货币战争”的核武器。

“费曼学习法”的五个要点

上面就是我用“费曼学习法”学习区块链的成果,前一部分是几年前认识“分布式数据存储”,后一部分是这次学习“共识机制”。
最后还是要回到文章的主题,总结一下“费曼学习法”的几个要点:
第一、遇到新知识,不要问别人,不要问别人,不要问别人。
怎么办呢?自己找资料,找出其中“关键的术语和规则”,用类比的方法,让自己讲明白其中的逻辑。
第二、如果特别复杂的定义,可以分成几部分,分别用不同的类比去解释。
第三、用已经学过的知识体系去“框”住新知识,就像“不可能三角形”让我忽然对“共识机制”的理解上了一个层次一样。
第四、根据知识的重要性,设置不同的目标,从“它是什么”到“它能干什么”,再到“它跟我有什么关系”,等等,从而提高你的理解层次;
第五、尝试用你理解的新知识,去解决实际问题,解释现实现象,你有可能发现新问题,或者让自己的理解更深刻。比如理解了“共识算法”后,就能意识到国家层面竞争的意义。
我发现,自从成为职业投资者之后,忽然一下子要面对大量的新知识,前年是云计算、区块链,锂电池,去年是人工智能、5G、网络安全,上半年是国产芯片、边缘计算、泛在物联网、燃料电池、自主可控,下半年又要重新学习区块链,费曼学习法的使用频率一下子高了很多倍。
虽然这些知识离自己的能力圈可谓十万八千里,但正因为如此,当你忽然明白了其中的核心逻辑,并与自己以往的知识产生关联之后,一下产生了“我靠,居然有这种神操作”,会体验到那种久违的愉悦感。
学习一时爽,用费曼学习法,天天学习天天爽。
AI并不像你想象的那么先进

梅勒妮·米切尔(Melanie Mitchell)写了她的新书《人工智能:思考人类的指南》(Artificial Intelligence: A Guide for Thinking Humans),因为她对人工智能究竟取得了多大进步感到困惑。她写道,她想“了解事情的真实状态”。
得知她的矛盾心理是一种安慰,因为她自己就是一名人工智能研究员。她是波特兰州立大学的计算机科学教授,也是著名的多学科研究中心圣达菲研究所(Santa Fe Institute)科学委员会的联合主席。如果米切尔对人工智能的立场都感到困惑,请原谅我们其他人的困惑,或者是谬误百出的见解。
正如米切尔所指出的那样,许多有关人工智能胜利的故事正在流传。这些报告中,最近在计算机视觉、语音识别、游戏和机器学习的其他方面的突破表明,人工智能可能会在未来几十年很大范围的任务中超越人类的能力。有些人觉得前景不可思议;另一些人担心“超人类”计算机可能会判定不需要我们人类在身边,并有能力做些与此有关的事。
我们要么离‘真正的’人工智能只有咫尺之遥,要么离了数百年。”
但也如米切尔另外证明的那样,即使是当今最强大的人工智能系统也有关键性的局限。它们只擅长于狭隘定义的任务,对外面的世界一无所知;它们在数据中发现相关性,而不考虑数据的含义,因此他们的预测可能是非常不可靠的;它们没有常识。
“要么取得了巨大的进展,要么几乎没有进展,”米切尔写道。“我们要么离‘真正的’人工智能只有咫尺之遥,要么离了数百年。”
米切尔解决问题的方法使这本书具有纪念意义和启发性。她对当今人工智能技术的耐心解释给人的印象是,真正的机器智能还很遥远。她表示,电脑不仅需要更好的大脑,还可能需要更好的身体。
米切尔提供了非常清晰易读的人工神经网络入门知识,该技术是图像识别,语言翻译和自动驾驶方面最新进展的核心。20世纪50年代和60年代,在最初的一些建立人工智能的尝试中使用了神经网络,但它们失宠了,因为看起来像一条死胡同,价值有限。但大约10年前有所改变,计算能力的进步使一种称为深度学习的数据密集型方法来训练神经网络成为可能。
跟随米切尔对神经网络的描述,你不需要了解繁杂的的数学。她展示了数学主要是什么,这就同时解释了它们的威力和缺陷。一种对识别图像内容特别有用的神经网络依赖于一种叫做“卷积”(convolution)的数学计算。处理文本的版本依赖于计算机表示语言统计方面的能力,即在穿过数百个维度的复杂“向量”里,单词在句子中出现的频率有多高。
令人印象深刻的是,人们已经将世界上如此多的方面进行了量化,以供计算机继续工作。同样值得注意的是,这些方法有如此多样的应用,比如检测肿瘤、自动驾驶和过滤垃圾邮件。但是这种伟大计算器的巧妙新用途并不一定赋予它们与我们的智力相当的能力。正如米切尔所指出的,让卷积神经网络(Convolutional Neural Networks, CNN)正常工作“需要大量的人类智慧”。
机器学习系统本质上是统计工作,所以很清楚,为什么它们很容易受到所馈送数据中的不准确、漏洞和其他缺点的影响。难怪如果神经网络在主要显示白人的图像上经过训练,它就不能识别黑人的脸。当一辆自动驾驶汽车无法识别一个有贴纸的停车标志,但(对人类来说)它仍然是一个明显的停车标志时,就并不奇怪。
幸运的是,这类问题已经引发了许多富有成果的讨论,这些讨论关于面部识别技术和自动决策的社会影响。纽约大学数据新闻学副教授梅雷迪思·布鲁萨德(Meredith Broussard)在2018年出版的《人工智能:计算机如何误解世界》(Artificial Unintelligence: How Computers The World)一书中有说服力地提出,无论你是否称它为“人工智能”,计算机仍然应该被当作是被我们这些好奇的人类使用的工具,人类应该始终处于这个范围内。
不过,尽管米歇尔并不是第一个指出机器学习系统弱点的人,她还是在评论中加了一层解释说,即使在它们处于最佳状态的时候,计算机可能也没有你想的那么好。在过去几年里,研究人员开发出了神经网络,他们声称,在识别照片或视频中的物体时,神经网络的表现达到甚至超过了人类的表现。这在新闻中被作为另一个必然对机器优势“抵抗无果”的例子。
米切尔指出,讨论的基准是一个基于名为ImageNet的大型图片数据库的测试。2017年,最优秀的计算机系统对来自ImageNet的图片进行了分类,正确率达98%的top-5正确率,据称超过了95%的人类正确率。(注:top-5准确率指排名前五的类别包含实际结果的准确率,即对一个图片,如果概率前五中包含正确答案,即认为正确。)
“top-5”的障碍是什么?这意味着正确的物体分类是机器作出的前五种猜测之一。米切尔写道:“如果给定一个篮球的图像,机器按这个顺序输出‘槌球’、‘比基尼’、‘疣猪’、‘篮球’和‘搬运车’,就被认为是正确的。top-5指标存在的原因可以理解:如果一张图片显示了不止一个物体,那么了解机器是否能检测出这些物体是很有用的。但它削弱了对极端技能的要求。米切尔表示,2017年,当该机器将正确的类别归置在其列表首位时,top-1的最高准确率仅为82%。(注:top-1准确率是指排名第一的类别与实际结果相符的准确率,即对一个图片,如果概率最大的是正确答案,才认为正确。)
至于说人类有95%的准确率,米切尔认为支持这一说法的数据站不住脚。在2015年发表的一个研究项目中,两个人尝试了ImageNet挑战的一部分。投入更多时间的人是安德烈·卡帕西(Andrej Karpathy),他现在是特斯拉的人工智能主管。以top-5准确率作为衡量标准,他错了5%。而现在,这个数字被用作人类表现的标准。
如果不是因为这个特殊测试的古怪之处,他的错误率可能会更低。卡帕西写道,他和另一名测试对象所犯错误的四分之一,不是因为他们对所看到的图片一无所知,而是因为他们不知道或不记得ImageNet中使用的一些确切的标签。
更糟糕的是,“据我所知,还没有人报道过机器和人类在top-1准确率上的比较,”米切尔写道。
凭借其快速和无尽的耐心,计算机是许多应用中图像识别的理想选择。在某些情况下,它们肯定比人类更准确。但说得太过了。“物体识别尚未接近被人工智能‘解决’的程度,”米切尔写道。
我很难想象我们需要什么样的突破才能制造出这样一台机器。”
人工智能目前最热门的话题之一是,如何让机器不仅检测数据中的统计相关性,而且在某种程度上理解它们正在处理的内容的意义。和米切尔一样,纽约大学的研究人员加里·马库斯(Gary Marcus)和欧内斯特·戴维斯(Ernest Davis)表示,如果没有这些改进,人工智能就不会“安全、智能或可靠”。在他们的新书《重启AI:构建我们可以信任的人工智能》(Rebooting A.I.:Building Artificial Intelligence We Can Trust)中,马库斯和戴维斯说,人们由于“可信度差距”而误以为计算机比它们更先进。
他们写道:“我们不得不从认知的角度来思考机器(‘它认为我删除了我的文件’),不管机器实际上可能遵循的规则多么简单。”
为了让机器变得不那么简单,许多研究人员正在重新探索用逻辑和常识来编码计算机的旧方法。以米切尔为例,她用类比的方式描述了她让计算机进行推理所做的努力。如果你想要一个电脑识别图像描绘“遛狗”,现在的基本方法是给它显示成千上万的遛狗的图片,然后使之相信那些照片中常见的事物——狗,皮带,手等。当机器看到之后遛狗的照片时,将触发一个积极的信号。然而,它可能会嗅出一些不寻常的遛狗行为。米切尔展示了一些例子,比如一张照片,一个人骑着自行车遛狗,另一只狗叼着另一只狗的皮带。她的研究小组正试图让计算机理解后一种情况是典型情况的“延伸”版本。
那样的工作是辛苦而缓慢的。即使它成功了——如果一台电脑可以在某种程度上理解“遛狗”可以有多种形式——如果这台机器自己从来没有遇到过狗,这种理解能有多丰富呢?
当我6岁左右的时候,我在我家附近的人行道上骑自行车,停下来看(也许还扔了) 一串从甜胶树上摘下来的带刺的种子球。突然,有人打开了街对面一所房子旁边的一扇门,出来一条棕色的狗,它犹豫了一两秒钟,然后径直扑过来,咬住我,撕破了我的灯芯绒裤子。这些记忆帮助我洞察到经历的无数方面——惊讶、恐惧和痛苦的感觉;一些狗的不可预测性;甜胶种子球的奇异古怪。相比之下,如果计算机被告知当人们说“something bit them in the ass”时并不总是一个习语,那就太肤浅了。(注:bite本意为“咬“,ass本意为“屁股”,bite (someone) in the ass指不当行为导致了不良后果。)
哲学家和其他人工智能怀疑论者一直认为,没有真实身体的电子大脑只能学到盒子里这点东西。许多人工智能研究人员将这种怀疑归咎于“某种残留的神秘主义”——正如认知科学家安迪·克拉克(Andy Clark)在1997年出版的《此在:重整大脑、身体和世界》(Being There: put Brain, Body, and World Together Again)一书中所写的那样,这是一种“对类似灵魂的精神实质的非科学信仰”。但是,当你考虑到爬行的婴儿能快速掌握基本概念,而数据中心的计算机需要大量的电力来吸收一个东西时,人工智能需要一个身体的这个想法就听起来相当不错。
米切尔似乎不情愿地转变为怀疑论者的立场。“在与人工智能搏斗多年之后,我发现关于身体化的争论越来越有说服力,”她写道。
那么,怎样才能制造出一个能在世界各地移动的机器人呢?这个机器人不仅能洞察自己的行为,还能洞察人类、动物和其他机器的行为。“我几乎无法想象,”她写道,“我们需要什么样的突破才能制造出这样一台机器。”
译者:Yoyo_J